Blazor gehört zum Produktivsten, was Microsoft je veröffentlicht hat, und ich habe mehrere Firmen dabei zugesehen, wie sie es weggeworfen haben. Nicht weil es schlecht wäre, sondern weil kaum jemand versteht, wofür er beim Betrieb eigentlich bezahlt. Und es ist nicht der WebSocket.
Ich habe fünf Jahre Blazor in Produktion hinter mir, in eigenen Projekten, in Kundenprojekten und im Code anderer Entwickler. In diesem Artikel zeige ich, warum Teams sich für Blazor entscheiden, warum manche wieder aussteigen und wo der echte Engpass liegt. Denn die übliche Erklärung ist falsch.
Warum entscheiden sich Unternehmen für Blazor?
Mit Blazor, besonders mit Komponentenbibliotheken wie Syncfusion, wird die Entwicklung extrem schnell und gut wartbar, bei sehr hoher Qualität.
Mit praktisch einem Strg+C und Strg+V setzt du ein komplettes Kanban-Board auf die Seite und kümmerst dich im @code-Block nur noch um Ein- und Ausgabe der Daten, statt Events, UI-Logik und Komponenten-Lebenszyklen zu verdrahten.
<SfKanban CssClass="kanban-overview" KeyField="Status" DataSource="@CardData" EnableTooltip="true">
    <KanbanColumns>
        <KanbanColumn HeaderText="To Do" KeyField="@(new List AllowToggle="true"></KanbanColumn>
        <KanbanColumn HeaderText="In Progress" KeyField="@(new List AllowToggle="true"></KanbanColumn>
        <KanbanColumn HeaderText="In Review" KeyField="@(new List AllowToggle="true"></KanbanColumn>
        <KanbanColumn HeaderText="Done" KeyField="@(new List AllowToggle="true"></KanbanColumn>
    </KanbanColumns>
    <KanbanCardSettings ContentField="Summary" HeaderField="Title" SelectionType="@SelectionType.Multiple"></KanbanCardSettings>
    <KanbanSwimlaneSettings KeyField="Assignee"></KanbanSwimlaneSettings>
</SfKanban>

@code {
    private List
Das Ergebnis:
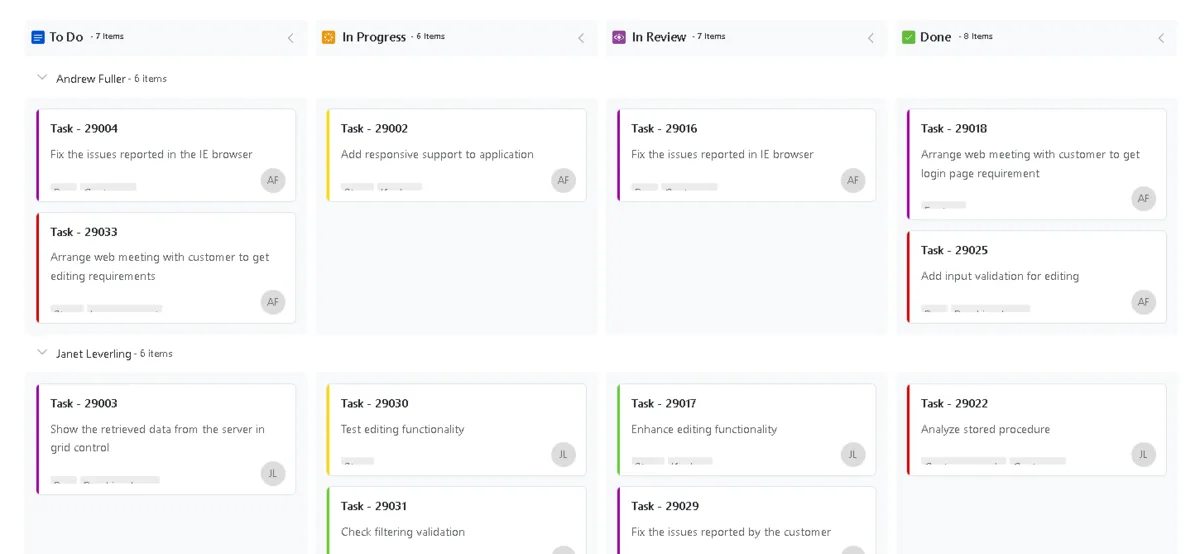
ℹ️Dokumentation und Live-Demo: https://blazor.syncfusion.com/demos/kanban/overview?theme=bootstrap5
Kurz zur Lizenz, weil danach immer gefragt wird. Syncfusion und Telerik sind kommerzielle Produkte, aber Syncfusion hat eine Community License, die deutlich mehr Leute abdeckt als die meisten denken: Firmen und Einzelpersonen mit weniger als 1 Million USD Bruttojahresumsatz, höchstens fünf Entwicklern und höchstens zehn Mitarbeitern. Eine Zusatzklausel sollte man kennen: die Organisation darf nie mehr als 3 Millionen USD an externem Kapital aufgenommen haben, etwa Private Equity oder Venture Capital. Als einzelner Entwickler liege ich klar darunter, und die meisten kleinen Firmen und Nebenprojekte ebenfalls. Wer nicht qualifiziert ist, findet in MudBlazor und Radzen kostenlose Alternativen mit einem großen Teil derselben Produktivität.
🚀 Ein einheitlicher Stack
Ein weiterer großer Vorteil: du musst nicht ständig mehrere Technologien gleichzeitig verfolgen.
Statt einen Back-end-Stack und einen völlig anderen Front-end-Stack zu beherrschen, nutzt du C# in der gesamten Anwendung. Entities, Validierungen und Geschäftslogik lassen sich direkt im Front-end wiederverwenden, geteilt über alle Schichten. Alles aus einer einzigen IDE.
Microsoft veröffentlicht jedes Jahr im November eine neue .NET-Version mit einer neuen C#-Version und einem Haufen Features. Und jetzt stell dir vor, du hältst zusätzlich mit einem komplett getrennten Ökosystem wie Angular, JavaScript, TypeScript und dem jeweils gerade angesagten Build-Tooling Schritt.
Wenn du dich nur um Blazor kümmern musst, kannst du diese Zeit in Design Patterns und Architektur stecken, statt Frameworks in zwei Sprachen hinterherzulaufen.
🧩 Weniger Komplexität
Je nach gewählter Architektur brauchst du nicht einmal eine API. Mit Blazor Server oder SSR kannst du Services und Repositories direkt in die Komponenten injizieren. Wird später doch eine API nötig, legst du sie als eigenes Projekt an. Diese Flexibilität nimmt viel Anfangskomplexität raus.
Wichtige Einschränkung: das gilt nur für die serverseitigen Render Modes. Blazor WebAssembly läuft im Browser und braucht deshalb immer eine API, um an die Daten zu kommen.
🌐 Integration mit Visual Studio und Azure
Die Integration mit Visual Studio und Azure ist hervorragend. Ein paar Klicks für ein Blazor-Projekt aus den Microsoft-Templates, ein paar weitere für die Veröffentlichung nach Azure. Für Teams, die ohnehin auf .NET arbeiten, spart das massiv Setup- und Deployment-Zeit.
📚 Dasselbe .NET-Ökosystem
Dieselben Pakete, die du im Back-end schon nutzt, funktionieren oft auch im Front-end. Alles läuft über NuGet. Weniger Technologien, die das Team lernen und betreuen muss.
💡Vorteil: Back-end-Entwickler können mit sehr flacher Lernkurve modernes Front-end bauen und mit Komponentenbibliotheken Dashboards, Grids, Charts und komplexe Oberflächen erstellen, ohne Experten für JavaScript-Frameworks zu werden.
🖥️ MAUI Blazor Hybrid
Es gibt ein Visual-Studio-Template namens MAUI Blazor Hybrid. Damit verwendest du Back-end und Front-end wieder und lieferst aus für:
- Web
- Windows
- macOS
- Android
- iOS
Praktisch dieselbe Codebasis, dieselbe IDE, dieselben Technologien. Aus Produktivitätssicht ist im Microsoft-Ökosystem schwer etwas Vergleichbares zu finden.
👥 Flexiblere Teams
Es gibt auch einen organisatorischen Vorteil. Wenn jemand in Urlaub geht oder ausfällt, übernimmt ein anderer Entwickler mit deutlich weniger Reibung. Die gesamte Anwendung lebt in einem Ökosystem, der Wissenstransfer ist dadurch viel einfacher.
🔄 Kontinuierliche Weiterentwicklung der Plattform
Wer Blazor wählt, investiert in eine Plattform, die Microsoft aktiv pflegt. Ein gutes Beispiel sind die Render Modes aus .NET 8. Damit entscheidest du pro Komponente, ob sie auf dem Server oder auf dem Client läuft. Genau dieses Feature macht die Architektur möglich, die ich weiter unten beschreibe.
⚡ Die Vorteile von Blazor in Kurzform
- ✅ Full-Stack-Entwicklung nur mit C#.
- ✅ Wiederverwendung von Entities, Validierungen und Geschäftsregeln zwischen Back-end und Front-end, auch plattformübergreifend.
- ✅ Weniger doppelter Code und höhere Produktivität.
- ✅ Schnelle UI-Entwicklung mit Komponentenbibliotheken wie Syncfusion, Telerik, MudBlazor oder Radzen.
- ✅ Native Integration mit Visual Studio, Identity, Dependency Injection und dem restlichen .NET-Ökosystem.
- ✅ Vereinfachtes Deployment nach Azure.
- ✅ Automatische CRUD-Generierung über Scaffolding.
- ✅ Blazor WebAssembly unterstützt Offline-Nutzung.
- ✅ Render Modes erlauben SSR, Server und Client im selben Projekt zu mischen.
⚠️ Warum scheitern manche Unternehmen dann mit Blazor?
Ich habe selbst erlebt, wie Firmen Blazor aufgegeben haben. Ich habe außerdem Freunde in großen Konzernen, unter anderem in der Automobilbranche, die wegen Performance umgestiegen sind.
Als letztes Jahr mein Kundenprojekt endete, war ich in mehreren Interviews, intern wie extern. Bemerkenswert war: der Hauptgrund, warum man mit mir sprechen wollte, waren fünf Jahre echtes Blazor in Produktion und der Kontakt zu Architekturen von ganz unterschiedlichen Entwicklern. Diese Kombination ist selten, und genau deshalb weiß ich, wo Teams falsch abbiegen.
Die übliche Erklärung lautet: „Blazor Server hält pro Nutzer einen SignalR-WebSocket offen, also skaliert es nicht." Das ist nicht direkt falsch, aber es ist die falsche Abstraktionsebene, und sie führt Teams zur falschen Lösung. Fangen wir bei dem an, was fast nie jemand definiert.
Zuerst: Was ist ein Circuit?
Ein Circuit ist die serverseitige Repräsentation einer aktiven Blazor-Sitzung. Öffnet ein Nutzer eine interaktive Seite, erzeugt der Server einen Circuit und hält ihn im Speicher, solange die Seite offen bleibt. Darin liegt:
- Der gerenderte Komponentenbaum, also die Hierarchie der Komponenteninstanzen samt ihrer jeweils letzten Render-Ausgabe
- Der Wert jedes Feldes und jeder Property in diesen Instanzen
- Jeder DI-Service, der auf diesen Circuit gescoped ist
- Der Zustand für JavaScript-Interop
Zwei Details, die dabei fast immer falsch verstanden werden.
Ein Circuit gilt pro Dokument, nicht pro Nutzer. Er entspricht dem Rendern eines einzelnen Dokuments im Browser. Zwei Tabs auf deiner Seite sind also zwei Circuits, zwei Zustände, zwei Verbindungen. Dieselbe Person kann dich dreimal kosten.
Ein Circuit lebt für die Sitzung, nicht für den Request. In MVC oder Razor Pages stirbt alles Allozierte, sobald die Response geschrieben ist. In einem Circuit bleibt es im Speicher, solange der Tab offen ist. Dieser eine Unterschied ist die Ursache fast jedes Skalierungsproblems, das ich in Blazor gesehen habe.
Es liegt nicht an Blazor. Es liegt an einem Render Mode.
Jetzt kommt die wichtigste Korrektur, und die, die ich mir vor Jahren gewünscht hätte.
Circuits existieren ausschließlich im Interactive Server. Eine Seite mit Static SSR hat weder Circuit noch WebSocket. Sie rendert HTML, beantwortet den Request, fertig. Das ist eine Razor Page mit Komponenten-Syntax.
„Blazor hält für jeden Nutzer eine SignalR-Verbindung offen" ist also keine Eigenschaft von Blazor. Es ist die Eigenschaft eines Render Modes. Hat eine Seite keine serverseitig interaktiven Komponenten, ist auch nichts offen.
Selbst im Interactive Server gibt es eine Feinheit: Blazor rendert die Seite zuerst statisch vor, und erst danach startet blazor.web.js den Circuit. Es gibt also ein Zeitfenster, in dem der Inhalt schon ausgeliefert ist und noch keine Verbindung existiert.
Deshalb ist „Blazor skaliert nicht" ein Kategorienfehler. Es ist kein Urteil über das Framework. Es ist ein Render Mode, den jemand ausgewählt hat, meist ohne zu merken, dass es überhaupt eine Wahl war.
Was tatsächlich über die Leitung geht
Viele nehmen an, der Circuit-Zustand werde durch den WebSocket geschoben. Wird er nicht, und das Warum erklärt das gesamte Kostenmodell. Eine Interaktion Schritt für Schritt:
- Du klickst. Der Browser schickt eine winzige Nachricht: eine Handler-ID plus die Event-Args. Ein paar Bytes.
- Der Server findet die Komponenteninstanz, die bereits in seinem Speicher liegt, ruft den Handler auf und rendert die Komponente in einen neuen Render Tree.
- Der Server vergleicht den neuen Render Tree mit dem vorherigen, den er aufbewahrt hat.
- Nur das Diff geht über den WebSocket zurück. Der Browser patcht das DOM.
Der Zustand verlässt den Server also nie. Über die Leitung geht eine Beschreibung dessen, was sich auf dem Bildschirm geändert hat.
Und genau deshalb muss der Server den vorherigen Render Tree im Speicher halten. Man kann „was sich geändert hat" nicht berechnen, ohne das „vorher" zu besitzen. Die Speicherkosten sind kein Unfall, sie sind der Preis für eine winzige Netzwerklast. Ein bewusster Trade-off im Design.
Zwei Dinge legen allerdings echte Bytes auf diese Verbindung, und die sollte man kennen:
- JavaScript-Interop serialisiert Daten in beide Richtungen. Schiebt eine Komponente per Interop ein Dataset an Chart.js, ist das echte Nutzlast und kein kleines Diff.
- Navigation zwischen Seiten läuft durch den Circuit statt über einen Page Load, der Routing-Verkehr liegt also ebenfalls auf dem Socket.
Und noch etwas: der WebSocket ist bevorzugt, nicht garantiert. SignalR handelt den Transport aus, und Blazor läuft am besten über WebSockets, wegen geringerer Latenz und höherer Zuverlässigkeit. Firmenproxies blockieren sie aber oft genug, und dann fällst du auf Long Polling oder Server-Sent Events zurück. Bei Long Polling wird jedes Event zu einem neuen HTTP-Request mit dem ganzen Header-Overhead, und die Latenz steigt. Der Circuit bleibt gleich, nur der Transport ist teuer geworden. Wer an Firmenkunden ausliefert, sollte damit rechnen.
Das echte Kostenmodell: pro Sitzung, nicht pro Request
Jetzt der Teil, auf den es wirklich ankommt. Vergiss die Debatte, ob WebSockets teuer sind. Die richtige Frage ist, in welcher Einheit dir abgerechnet wird.
Bei HTTP sind deine Kosten proportional zu den Requests in Bearbeitung. Beim Interactive Server sind sie proportional zu den anwesenden Sitzungen.
Tausend Leute, die eine Razor Page lesen, bedeuten vielleicht zwanzig gleichzeitige Requests. Die anderen 980 sitzen da und lesen und kosten dich nichts. Beim Interactive Server halten dieselben 980 Leute 980 Circuits und 980 Verbindungen. Ein untätiger Nutzer ist nicht kostenlos. Er ist nicht einmal still: es gibt ein periodisches Keepalive zwischen Server und Client, wer also einen Tab geöffnet hat und essen gegangen ist, erzeugt weiterhin Verkehr und hält alles am Leben.
Diese Kosten pro Sitzung haben zwei Komponenten, und ich halte es für ehrlicher, beide genau zu benennen, statt einen Schuldigen zu küren.
Der Circuit. Microsoft veranschlagt rund 250 KB für eine minimale Hello-World-App und empfiehlt, für 5.000 gleichzeitige Nutzer mindestens 1,3 GB einzuplanen, also etwa 273 KB pro Nutzer. Ihre Dimensionierungsformel ist denkbar simpel:
Verfügbarer Speicher / Speicher pro Circuit = maximale Anzahl aktiver Circuits
Und 250 KB sind die Untergrenze, nicht dein Wert. Wenn du für ein Grid eine List mit 5.000 Zeilen in einem Komponentenfeld hältst, liegt diese Liste pro Circuit im Speicher, die ganze Sitzung lang. Dann bist du bei mehreren MB pro Nutzer, nicht bei 273 KB.
Die Verbindung. Microsofts eigene SignalR-Skalierungshinweise sind hier ebenso deutlich. Normale HTTP-Clients nutzen kurzlebige Verbindungen, die sich schließen, wenn der Client untätig wird, während eine SignalR-Verbindung dauerhaft ist und auch dann offen bleibt, wenn der Client nichts tut. In einer Anwendung mit hohem Traffic und vielen Clients können diese dauerhaften Verbindungen den Server an sein Verbindungslimit bringen, und sie verbrauchen zusätzlichen Speicher, um jede einzelne zu verwalten. Es gibt eine noch unangenehmere Folge: belegt SignalR die letzten freien TCP-Verbindungen, bleiben für andere Anwendungen auf demselben Server keine mehr übrig, und du siehst zufällige Socket-Fehler und Connection Resets.
Welche der beiden dich umwirft, hängt vollständig vom Szenario ab, und das sage ich lieber offen, als einen Alleinschuldigen auszurufen:
- Interne Dashboards, authentifizierte Nutzer, lange Sitzungen: hier dominiert der Circuit deutlich. Genau hier stellen fast alle die falsche Diagnose, geben dem WebSocket die Schuld und schreiben grundlos in React neu.
- Öffentliche Seiten mit hohem Traffic: hier beißen beide, und die Verbindungsgrenze wird oft zuerst erreicht. Das Symptom sind Socket-Fehler, nicht Speichermangel, du starrst also auf eine gesunde RAM-Kurve, während die Seite umkippt.
In keinem der beiden Fälle ist die Antwort ein größerer Server. Die Antwort ist, keine Circuits dorthin zu setzen, wo sie nicht hingehören.
Öffentliche Seiten sind der schlimmste Fall
Öffentlicher Traffic bricht das Interactive-Server-Modell auf Arten, die man leicht übersieht, bis man live ist:
- Bots und Crawler öffnen Circuits wie alle anderen. Google, Bing, Scraper, Uptime-Monitore. Keiner davon wird je einen Button drücken. Alle kosten dich etwas.
- Bounce-Traffic ist brutal. Jemand kommt aus der Suche, liest drei Sekunden, schließt den Tab. Dieser Circuit liegt standardmäßig drei Minuten im Pool getrennter Circuits. Deine Zahl gleichzeitiger Verbindungen liegt weit über deinem gleichzeitigen Publikum.
- Lastspitzen werden zu Verbindungsstürmen, nicht zu Request-Warteschlangen. Bei HTTP läuft eine Spitze ab. Beim Interactive Server kommen alle an und bleiben.
- PaaS-Tarife begrenzen gleichzeitige WebSockets. Azure App Service hat Limits pro Tier, und in den unteren Tarifen ist die Zahl kleiner, als man erwartet. Prüf die aktuelle Tabelle, bevor du dimensionierst.
Das ist der größte Architekturfehler, den ich sehe: Interactive Server auf die öffentliche Oberfläche einer Seite zu setzen, weil es im Template so voreingestellt war.
Drei Fehler, die ich immer wieder sehe
Das sind die Fehler, in die ich Architekten und Senior Engineers mit jahrzehntelanger Erfahrung volle Fahrt hineinlaufen sah. Leute, die von Angular oder React kamen, annahmen, Blazor funktioniere genauso, und nie ein Buch dazu aufgeschlagen haben.
1. Scoped gilt pro Circuit, nicht pro Request. Dieser hier tötet Projekte. Du registrierst AddScoped so, wie du es in MVC immer gemacht hast. Dort lebt der Context etwa 200 ms. In einem Circuit lebt er die gesamte Sitzung. Der Change Tracker sammelt stundenlang Entities an, eine Verbindung aus dem Pool bleibt belegt, und EF Core ist nicht thread-safe für die parallelen Renders, die Blazor auslösen kann. Nimm AddDbContextFactory und erzeuge den Context pro Operation.
2. Große Collections in Komponentenfeldern. Alles, was du einem Feld zuweist, bleibt die ganze Sitzung im Speicher. Lade die Daten seitenweise statt komplett, nutze Virtualisierung und leere Collections im IDisposable, wenn die Komponente verschwindet.
3. Das Schließen des Tabs gibt den Speicher nicht sofort frei. Bricht die Verbindung ab, schiebt Blazor eine begrenzte Anzahl Circuits in einen Pool getrennter Circuits, damit der Client sich wieder verbinden kann, standardmäßig drei Minuten lang. Schlimmer noch: ein getrennter Circuit kann weiterarbeiten und dabei CPU und Speicher verbrauchen. Beides lässt sich über DisconnectedCircuitRetentionPeriod und MaxRetainedDisconnectedCircuits konfigurieren. Viele Teams sehen die Speicherkurve nach einer Spitze nicht fallen und diagnostizieren ein Leck, das keines ist.
Die Latenz beißt vor der Last
Es gibt einen zweiten Fehlermodus, der nichts mit Kapazität zu tun hat. Jedes UI-Event ist ein Roundtrip. Ein @bind auf oninput schickt eine Nachricht pro Tastendruck.
Nutzer in São Paulo, Server in East US, 120 ms pro Tastendruck. Die Oberfläche fühlt sich kaputt an, bei zehn Leuten online. Das bringt Entwickler dazu, „Blazor ist langsam" zu schließen, ohne je in die Nähe eines Ressourcenlimits gekommen zu sein. Die Lösung ist kein größerer Server, sondern diese Komponente auf den Client zu verschieben.
Der häufigste Fehler
Der Entwickler sieht die Symptome und schließt: „Blazor skaliert nicht." Dann wird die Technologie aufgegeben und in einem JavaScript-Framework neu geschrieben, meist zu enormen Kosten, obwohl die eigentliche Lösung ein anderer Render Mode und eine geänderte DI-Registrierung gewesen wäre.
Der zweite häufige Fehler ist, JavaScript-Entwickler ohne Schulung auf Blazor zu setzen. Die Syntax wirkt zugänglich genug, dass man das Lernen überspringt, aber die Best Practices sind völlig andere, und die wichtigsten davon stehen genau oben.
Wie man es löst
Sobald klar ist, dass du pro Sitzung und nicht pro Request bezahlst, liegen die Optionen auf der Hand:
- Render Modes. Entscheide pro Komponente, wo sie läuft. Das ist dein wirkungsvollstes Werkzeug, und deshalb hat .NET 8 die Diskussion verändert.
- Static SSR für öffentliche Seiten ohne Interaktivität. Kein Circuit, keine Verbindung, keine Kosten pro Sitzung.
- Blazor WebAssembly mit APIs für interaktive öffentliche Features. Der Zustand wandert in den Browser des Nutzers und skaliert damit kostenlos.
- Interactive Server für interne Dashboards und Admin-Bereiche mit bekannter, begrenzter Nutzerzahl. Dort spielt er seine Stärken aus, und dort lohnt die Produktivität den Preis.
- Hybride Architekturen, die all das in einer Anwendung kombinieren.
WebAssembly ist ebenfalls kein Selbstläufer, und das will ich klar sagen. Du bezahlst den Download der .NET-Runtime beim ersten Besuch, der Start ist langsamer, die Nutzlast schwerer und das Debugging schlechter. Auf einer öffentlichen Seite, bei der der erste Seitenaufbau zählt, kann dieser Tausch genauso wehtun wie zuvor der Circuit. Miss beides.
⚠️Azure SignalR Service tut nicht das, was die meisten glauben. Es nimmt die Verbindungsverwaltung von deinem Server, was bei der Verbindungshälfte des Problems wirklich hilft. Aber der Circuit liegt weiterhin im Speicher deiner Anwendung. Du hast den Transport ausgelagert, nicht den Zustand. Teams kaufen es in der Erwartung einer vollständigen Skalierungslösung und werden enttäuscht, aus genau dem Grund, um den es in diesem Artikel geht.
💡 Das unterschätzteste Framework im .NET-Ökosystem
Jetzt kommt der aus meiner Sicht interessanteste Teil.
ASP.NET Razor Pages
Razor Pages ist vermutlich das unterschätzteste Framework im .NET-Ökosystem. Es gibt dir fast alles, was Leute überhaupt erst zu Blazor zieht:
- C#
- .NET
- Razor-Syntax
- Gemeinsamer Code mit dem Back-end
- Komponentenbibliotheken wie Syncfusion
Aber mit weit geringerem Overhead für öffentliche Seiten mit hohem Traffic, weil es weder Circuit noch dauerhafte Verbindung zu unterhalten gibt.
Wie es funktioniert
Razor Pages ist eine native HTTP-Architektur. Jede Seite hat ihre eigene View und ihr eigenes Code-Behind, das den Request behandelt. Zustandslos, cachebar, und jede Instanz bedient jeden Nutzer. Für öffentliche Seiten unter schwerer Last ist das extrem effizient, und es führt zurück zum Modell, in dem ein stiller Leser dich nichts kostet.
🌍 Wie diese Website gebaut ist
Die Seite, die du gerade liest, nutzt genau diesen hybriden Ansatz. Die öffentlichen Seiten, die Traffic aus Suche und sozialen Netzwerken bekommen, sind Razor Pages. Das Dashboard nutzt Blazor Render Modes. Charts und schwerere clientseitige Features laufen im Browser. Die Administration, etwa die Artikelverwaltung, nutzt Interactive Server Rendering, weil es eine Handvoll authentifizierter Nutzer sind und das SPA-artige Gefühl den Circuit wert ist. Und wenn ich eine JavaScript-Bibliothek brauche, kann ich sie weiterhin einbinden und ohne großen Aufwand mit C# synchronisieren.
Das ist der Punkt. Es ging nie um Blazor oder nicht Blazor. Es geht darum, für jeden Teil der Anwendung den richtigen Render Mode zu wählen.
ℹ️Erwähnenswert: nichts davon hat mit Copilot, Claude Code oder Codex zu tun. Lange bevor es KI-Agenten gab, war Blazor bereits ein Produktivitäts-Hack. Wir haben dank Entity-Scaffolding ganze Portale in zwei Wochen gebaut. Entity mit ihren Properties anlegen, daraus die Seiten für Insert, Update, Delete und List generieren, inklusive Basisvalidierungen, ASP.NET-Identity-Berechtigungen und responsivem Bootstrap-Layout. Danach mussten wir nur noch die Geschäftsregeln ergänzen.
🏁 Fazit
Blazor scheitert nicht daran, dass es nicht skalieren könnte. Es scheitert daran, dass Teams es mit einem mentalen Modell aus zustandslosen Web-Frameworks einführen und dieses Modell nie aktualisieren.
Wenn du nur eine Sache aus diesem Artikel mitnimmst, dann diese: Blazor Server zu skalieren heißt nicht, Verbindungen zu skalieren, sondern Zustand. Sobald das sitzt, treffen sich die Entscheidungen von selbst. Circuits für interaktive, authentifizierte Bildschirme mit begrenztem Publikum. Static SSR oder Razor Pages für die öffentliche Oberfläche, die echten Traffic abbekommt. WebAssembly, wenn du Interaktivität willst, ohne Zustand auf dem Server zu halten, und bereit bist, den Startpreis zu zahlen.
Die Teams, die ich bei Blazor aufgeben sah, lagen bei den Symptomen nicht falsch. Sie lagen bei der Ursache falsch, und das kostete sie eine Neuentwicklung, die sie nie gebraucht hätten.
Wenn du davon etwas in Produktion erlebt hast, lese ich gern in den Kommentaren davon. Über Fehlerfälle zu schreiben ist deutlich nützlicher als über den Happy Path.

Comentários (0)
Deixe um Comentário
Seja o primeiro a comentar!